顯示具有 人工智慧 標籤的文章。 顯示所有文章

2021年11月20日 星期六

減少卷積神經網路的層數,參數量就一定會減少嗎?答案可能相反!

標題:減少卷積神經網路的層數,參數量就一定會減少嗎?答案可能相反!


前言:

在建置影像的卷積神經網路模型時,過度配適(過擬合,overfitting)的現象常常在樣本數不足的情況出現,除了想辦法透過資料擴增遷移學習的方法解決這個問題外,神經網路的模型參數量過大往往是更容易造成此問題的重要因素。

但是,不少初學者透過減少"卷積層及池化層"的方式減少模型的大小,但是這個動作在"某些情況"反而造成模型的參數量更大

本文透過實際計算參數量的方式,講述"減少卷積層及池化層"時"參數量反而越來越大"的情況。


-----------分隔線-----------

卷積運算的介紹:

卷積運算相當於濾鏡運算,簡單來說,我們用下圖的例子作為範例。

這是常見的卷積運算,但如果是有3個色板的RGB影像,該如何計算呢,請見下圖。


三個色板,進行了三種不同的卷積核(kernel)的運算後,加在一起,這時,神經網路需要更新的參數量為27(3個色板乘上3×3的kernel)個,也就是說,無論影像多大,卷積層的參數量都不變

如果第一層卷積層的輸出為32個色板,那麼,上面這張圖的運算就會有32次,再將這32個輸出合併為同一個張量的32個色板,不過這32次卷積運算中,參數的數值會不同。

在這裡,參數量為3×(3×3)×32=864(與圖片大小無關)

如果第二層卷積層的輸出為64個色板,那麼,就可以想像成,上面那張圖的左邊有32個4×4大小的圖片,再乘上3×3大小的核(kernel),由於這個動作只會輸出一個色板,所以類似此運算會做64次。

在這裡,參數量為32×(3×3)×64=18,432(與圖片大小無關)


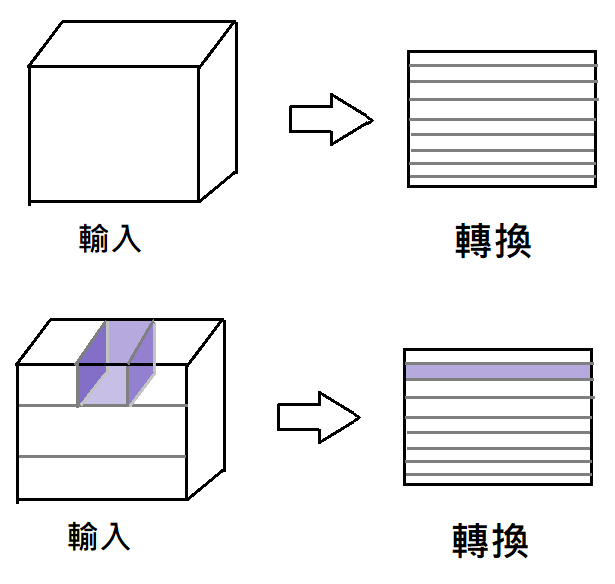
看到這裡,可能會覺得,卷積神經網路其實是在進行3D的卷積運算(像下圖這樣),其實在實作時通常還是2D的運算。(見更下一張圖)

程式庫在進行運算時,通常會將3D的輸入轉換成2D的輸入(如下圖),這樣做的好處,就是能利用線性代數的程式庫陣列的計算最佳化


像下圖這樣,將3D的輸入和核都轉成二維矩陣時,就可以透過2維的乘法運算,快速完成3D的卷積運算,算完後再轉換回3D的大小


然而,為什麼減少神經網路的層數時在部分情況反而會造成模型的參數量更大呢,原因就出在平坦層後方的全連結層


-----------分隔線-----------


全連結層的矩陣乘積運算:

先看下圖,你可以看到,全連結層的運算模擬圖(輸入的大小為2、隱藏層的神經元大小為3)。

在這裡,看起來,隱藏層的參數量就是6個(不考慮偏權值)。


實際上,它就是在進行一種矩陣相乘的運算,如下圖。
這就是常見到的,Y=X×W+B。


所以很容易就能看出來,W的數量並不是神經元數量,而是線的數量

那麼,如果平坦化後的結果是32,768個數字,在下一層的全連結層的輸出有128個神經元時,就會有32,768×128= 4,194,304個參數

這一層的參數量遠遠比前面所有的卷積運算的參數量加起來都還大。

而這一層的參數量,跟圖片的大小有間接關係。

-----------分隔線-----------

現在來以例子來計算吧。

圖片的輸入為224*224的大小,有RGB三個色板。

模型為:

input→32個filter的3×3濾鏡→2×2池化層→64個filter的3×3濾鏡→2×2池化層→128個filter的3×3濾鏡→2×2池化層→256個filter的3×3濾鏡→2×2池化層→平坦層→128個神經元的全連結層→2個神經元的輸出層。

然後,為了縮減模型的大小,弄巧成拙減少了一層卷積層和池化層

input→32個filter的3×3濾鏡→2×2池化層→64個filter的3×3濾鏡→2×2池化層→128個filter的3×3濾鏡→2×2池化層→平坦層→128個神經元的全連結層→2個神經元的輸出層。

兩者的差異如下(不考慮偏權值)

第一個模型的參數量(六百萬個參數):

3×(3×3)×32→0→32×(3×3)×64→0→64×(3×3)×128→0→128×(3×3)×256→0→0→[14×14×256]×128→128×2=864+18,432+73,728+294,912+[6,422,528]+256=6,810,720。

第二個弄巧成拙的模型參數量(一千兩百萬個參數):

3×(3×3)×32→0→32×(3×3)×64→0→64×(3×3)×128→0→0→[28×28×128]×128→128×2=864+18,432+73,728+[12,845,056]+256=12,938,336。

由上述計算可算出,減少了一層卷積層和池化層後,由於能縮減四分之三參數的池化層減少了少了池化層後,圖片的大小14×14變成28×28,接上全連結層後,參數量反而增加了

所以,如果要減少模型的大小,不妨先注意平坦層後方的全連結層。

另外,使用全域平均池化,可以將所有色板直接取平均值,只留下一個數值,這樣的話是能顯著減少那一層的參數量的,這是一個好方法。


真棒,今天又學到了很多東西呢!

2020年2月10日 星期一

[密技]解決keras的loss卡在0.69不下降的問題

剛剛使用Keras卷積神經網路訓練模型時,遇到一個可怕的狀況:
無論參數怎麼調,loss始終卡在0.69,即使一開始不為0.69,過了幾個epoch後loss依然會回到0.69

解決方法:

2019年7月7日 星期日

使用Keras卷積神經網路辨別肺部醫學影像(五)

上一張「使用Keras卷積神經網路辨別肺部醫學影像(四)

在上一章,我們撰寫了訓練檔的程式碼,現在來執行它,請注意,第一次執行時,其中的
from keras.models import load_model 
這一行請先註解掉。

執行時會出現這個畫面。

請稍等一會兒,因為它需要訓練很長的一段時間。

解析:
Epoch是目前訓練到第幾批次。
538s代表這一批次訓練花了多少時間。
loss是耗費了多少損失。
acc是準確度。

我們暫時不考慮過擬合的問題,因為這只是寫給初學者作練習用的,也只是給我這個初次寫教學文的新手練習寫文章的,我不想搞那麼複雜。

常態上來說,假設訓練模型正確,loss將會逐漸縮小,acc將逐漸增加(此圖片僅為參考,並非此程式的記錄)。
以這張圖片來說,這個訓練模型算合格的了。

由於訓練需要大量時間,而且會消耗許多運算資源,所以可以在訓練到一半時輸出權重:
model.save_weights("Fiborsis_sex.h5")

然後下次執行時把這一行取消註解:
from keras.models import load_model 

這樣子下次訓練時就可以接續上次的存檔繼續訓練,不必從頭開始。

訓練到一定的程度之後,我們輸出結果:

model.save("Fiborsis_sex_result.h5")

稍後就可以在驗證檔中使用它。

我們現在建立一個check0的python檔案,程式碼如下: 


import array
import sys
import numpy as np
import cv2
import glob
#設定亂數
import random
from keras.utils import np_utils
np.random.seed(0)

#設定影像的長寬
imgwidth=128
imgheight=128

#匯入需要用到的東西
from keras.models import Sequential
from keras.layers import Dense,Dropout,Activation,Flatten
from keras.layers import Conv2D,MaxPooling2D,ZeroPadding2D


model=Sequential()

from keras.models import load_model
#載入剛剛訓練好的訓練檔
model=load_model("Fiborsis_sex_result.h5")

print('載入資料')

#建立影像清單
imglist=[]
#匯入一張圖片
filestr='image_F/00001474_000.png'
img = cv2.imread(filestr,cv2.IMREAD_GRAYSCALE)
#resize它的大小
img=cv2.resize(img,(imgwidth,imgheight))
#將像素的數字縮小為0~1之間的數字
img=img/255.0
#將這張圖片加入imglist
imglist.append(img)  
#轉換成numpy的array
x_img_test=np.array(imglist)
#進行reshape動作
x_img_test=np.reshape(x_img_test,(1,imgwidth,imgheight,1))

#預測這張圖是男生還是女生
prediction=model.predict(x_img_test)
#輸出機率
print("男性機率",(int)(prediction[0][0]*100),"%")
print("女性機率",(int)(prediction[0][1]*100),"%")

現在來執行這個程式。
執行結果,這張圖是女性的機率高達99%,而這張圖的確是女性沒錯,所以這次的測試是成功的。

不過記得要拿沒加入訓練檔訓練過的圖片來作測試,比較符合實際狀況,這是為了避免「過擬合」的問題,不過這不是本章所要討論的重點。

好了,本系列「使用Keras卷積神經網路辨別肺部醫學影像」教學文就在此告一段落了,以後有機會再接續著寫下去,那我們下次再見囉。


2019年5月6日 星期一

使用Keras卷積神經網路辨別肺部醫學影像(四)

上一章「使用Keras卷積神經網路辨別肺部醫學影像(三)」

在上一章,我們得到了一個.npy檔,裡面裝著4500張男性影像和4500張女性影像。
在這一章,我們將建立訓練模型,並輸出成.h5的檔案 


在開始之前,需要理解下列名詞:
  • 卷積層
  • 池化層
  • Onehot encoding
  • 平坦層
  • 隱藏層
  • 輸出層
  • 活化函數
  • 損失函數

CNN卷積神經網路可分為兩大部分:
  • 影像的特徵提取:卷積層、池化層
  • 完全連結神經網路:平坦層、隱藏層、輸出層


關於卷積運算: 
卷積層的意義是將一個影像進行卷積運算,產生多個影像。 我們在進行影像操作時會使用到濾鏡,不同的濾鏡套用到影像中會產生不同的影像,可幫助程式提取不同的特徵。 

關於縮減取樣:
 池化層中的Max-Pool運算可將影像進行縮減取樣,例如一張14x14的影像,進行Max-Pool運算後,縮小為7x7的影像。  

關於Onehot encoding: 經過Onehot encoding轉換,可幫助程式進行分類。 
例如數字3,可轉換為[0,0,0,1,0,0,0,0,0,0] 
例如數字8,可轉換為[0,0,0,0,0,0,0,0,1,0] 

關於神經網路: 
有個公式是:輸出=活化函數(輸入X權重X偏差) 
例如現有250個輸入神經元,每個神經元乘上一個權重並加上偏差之後,可以傳遞到第二層(隱藏層)。 
在隱藏層又乘上權重並加上偏差之後,可將結果傳達到第三層(輸出層或第二層隱藏層)。

關於活化函數:
當神經元接收刺激時(輸入X權重+輸出)經過活化函數的運算,大於臨界值會傳遞到下一個神經元。

關於損失函數:

損失函數用以計算誤差,從錯誤中學習。


建立一個train_4500x4500的python檔案,程式碼如下:


import array import sys 
import numpy as np 
import cv2 
import glob 
import random from keras.utils 
import np_utils from keras.models 
import Sequential from keras.layers 
import Dense,Dropout,Activation,Flatten from keras.layers 
import Conv2D,MaxPooling2D,ZeroPadding2D 

#設定亂數種子,讓每次訓練產生的結果相同 np.random.seed(0) 

#產生性別標籤清單 
labellist=[] 

#設定影像寬度、高度 
imgwidth=128 imgheight=128 
#將上次產生的.npy檔載入至名為x_img_train的Array中 x_img_train=np.load("size128_F4500_M4500.npy") 
#設定前4500個影像標籤為女性(用數字1表示) 
for i in range(0,4500): 
(四個空格)labellist.append(1) 
#設定後4500個影像標籤為男性(用數字0表示) 
for i in range(4500,9000):
(四個空格)labellist.append(0) 
#將性別標籤轉換成Array 
y_label_train=np.array(labellist, dtype=np.int32) 
#將x_img_train轉換成(9000x128x128x1)的四維陣列 x_img_train=np.reshape(x_img_train,9000,imgwidth,imgheight,1))
#將性別標籤進行Onehot encoding轉換 y_label_train_OneHot=np_utils.to_categorical(y_label_train) 
#建立模型 
model=Sequential() 
#建立卷積層1 
model.add(Conv2D(filters=32,kernel_size=(5,5),input_shape=(imgwidth,imgheight,1),activation='relu',padding='same')) 
#隨機釋放神經元 
model.add(Dropout(rate=0.3)) 
#建立池化層1 
model.add(MaxPooling2D(pool_size=(2,2)))
#建立卷積層2 
model.add(Conv2D(filters=64,kernel_size=(5,5),activation='relu',padding='same')) 
#隨機釋放神經元 
model.add(Dropout(0.3)) 
#建立池化層2 
model.add(MaxPooling2D(pool_size=(2,2))) 
#建立卷積層3 
model.add(Conv2D(filters=128,kernel_size=(5,5),activation='relu',padding='same')) 
#隨機釋放神經元 
model.add(Dropout(0.5)) 
#建立池化層3 
model.add(MaxPooling2D(pool_size=(2,2))) 
#建立平坦層 
model.add(Flatten()) 
#隨機釋放神經元 
model.add(Dropout(rate=0.25)) 
#建立隱藏層 
model.add(Dense(512,activation='relu')) 
#隨機釋放神經元 
model.add(Dropout(rate=0.4)) 
#建立輸出層 
model.add(Dense(2,activation='softmax')) 
#定義訓練方式 model.compile(loss='categorical_crossentropy',optimizer='adam',metrics=['accuracy']) 
#設定訓練用的函數 
def training(times):
(四個空格)train_history=model.fit(x_img_train,y_label_train_OneHot,shuffle=True,epochs=times,batch_size=128,verbose=2) 
#如未完成訓練,可載入上次產生的訓練檔接續訓練
from keras.models import load_model #model.load_weights("Fiborsis_sex.h5")
#訓練1回,每回訓練20次 
for k in range(1): 
(四個空格)print('訓練第:',k,'次') 
training(20)
#輸出權重 
model.save_weights("Fiborsis_sex.h5")
#輸出模型檔 
model.save("Fiborsis_sex_result.h5")


程式碼解說: 我們一開始建立影像清單(labellist),並按照上次產生的size128_F4500_M4500.npy檔案中的性別順序填入標籤(女性為1男性為0)。  
for i in range(0,4500):
    labellist.append(1) 
for i in range(4500,9000):
    labellist.append(0) 

接著對資料進行前置處理。
y_label_train=np.array(labellist, dtype=np.int32) x_img_train=np.reshape(x_img_train,9000,imgwidth,imgheight,1)) y_label_train_OneHot=np_utils.to_categorical(y_label_train) 

建立卷積層,讓程式隨機產生32個濾鏡,每個濾鏡為5x5的大小,輸入的形狀為(寬度,長度,1),活化函數為relu 。
model.add(Conv2D(filters=32,kernel_size=(5,5),input_shape=(imgwidth,imgheight,1),activation='relu',padding='same')) 

為了防止過度擬合的現象發生,隨機放棄30%的神經元。
 model.add(Dropout(rate=0.3)) 

將圖片縮小,進行縮減取樣。 
model.add(MaxPooling2D(pool_size=(2,2)))  

再次建立卷積層,共產生64個濾鏡,每個濾鏡為5x5的大小,輸入的形狀為(寬度,長度,1),活化函數為relu 。
model.add(Conv2D(filters=64,kernel_size=(5,5),activation='relu',padding='same')) 

隨機放棄30%的神經元
 model.add(Dropout(rate=0.3)) 

進行縮減取樣(然後依此類推)。 
model.add(MaxPooling2D(pool_size=(2,2)))  

輸出結果,共有兩種結果 。
model.add(Dense(2,activation='softmax')) 

執行訓練,輸入x_img_train,引入y_label_train_OneHot做為參考解答。
啟動shuffle將資料順序打亂。 epochs代表進行幾次訓練周期,batch_size為每一批次共有幾筆資料,verbose=2代表顯示訓練過程。
train_history=model.fit(x_img_train,y_label_train_OneHot,shuffle=True,epochs=times,batch_size=128,verbose=2)

將訓練到一半的model儲存起來,下次可接續訓練(Fiborsis_sex.h5為檔名)
model.save_weights("Fiborsis_sex.h5")

載入上次儲存的模行檔(Fiborsis_sex.h5為檔名)
model.load_weights("Fiborsis_sex.h5")

輸出模型檔 (Fiborsis_sex_result.h5為檔名)
model.save("Fiborsis_sex_result.h5")


在下一個章節,我們將執行訓練檔,並驗證結果。

下一章「使用Keras卷積神經網路辨別肺部醫學影像(五)」

2019年4月22日 星期一

使用Keras卷積神經網路辨別肺部醫學影像(三)

上一章「使用Keras卷積神經網路辨別肺部醫學影像(二)」

由上一個步驟已經得到了兩個分別裝著男性肺部影像與女性肺部影像的資料夾。


接著我們將把這些影像壓縮成一個.npy檔。

至於為什麼要做壓縮呢,因為後續進行訓練的時候,如果是一張一張影像慢慢讀進程式,會拖累執行的效能。而且比起一個檔案,數千張的影像檔在攜帶上也不方便,全部壓縮在一個檔案是很方便的。

現在,我們建立一個python程式,命名為small128.py

程式碼及註解如下:
import array
import numpy as np
import cv2
import glob
#建立影像清單
imglist=[]
#計數器
filecount=0
#設定圖片寬度
imgwidth=128
#設定圖片高度
imgheight=128
#迭代女性資料夾中的影像
for filestr in glob.glob('image_F/*.png'):
    #利用opencv讀取影像檔
    #參數中的IMREAD_GRAYSCALE代表是以灰階模式讀取而非全彩
    img = cv2.imread(filestr,cv2.IMREAD_GRAYSCALE)
    #將影像縮放為128x128的大小
    img=cv2.resize(img,(imgwidth,imgheight))
    #將每個像素的值由0-255的整數轉換為0-1的浮點數
    img=img/255.0
    #將處理過後的影像放入影像清單中
    imglist.append(img)
    #計算目前處理了幾張影像
    filecount=filecount+1
    #進度條,查看目前程式跑到哪了
    if filecount%100==0:
        print(filecount,end=' ')
    #設定只放入4500張影像
    if filecount>=4500:
        break
#迭代男性資料夾中的影像
for filestr in glob.glob('image_M/*.png'):
    #利用opencv讀取影像檔
    #參數中的IMREAD_GRAYSCALE代表是以灰階模式讀取而非全彩
    img = cv2.imread(filestr,cv2.IMREAD_GRAYSCALE)
    #將影像縮放為128x128的大小
    img=cv2.resize(img,(imgwidth,imgheight))
    #將每個像素的值由0-255的整數轉換為0-1的浮點數
    img=img/255.0
    #將處理過後的影像放入影像清單中
    imglist.append(img)
    #計算目前處理了幾張影像
    filecount=filecount+1
    #進度條,查看目前程式跑到哪了
    if filecount%100==0:
        print(filecount,end=' ')
    #設定只放入4500張影像(加上女性的影像共9000張)
    if filecount>=9000:
        break
#將影像清單轉換成Array
img_array=np.array(imglist)
#儲存影像
np.save("size128_F4500_M4500.npy",img_array)

我們一開始建立影像清單,並設定好影像的大小(影像越大,訓練時就需要消耗更多的資源,所以建議縮小影像),我們將影像統一縮放為長128px、寬128px的大小
imglist=[]
imgwidth=128
imgheight=128

接著我們利用OpenCV讀取影像(需import cv2)。
img = cv2.imread(filestr,cv2.IMREAD_GRAYSCALE)
讀取時我們將原本的彩色影像轉換成灰階影像(全彩的影像每個像素需佔用24位元的大小,灰階的影像只需佔用8個位元),此動作並不會降低訓練的準確度,因為這些肺部影像本來就是黑白的。

接著我們使用OpenCV的resize函數,將影像縮放為一開始設定好的128x128的大小,此部分不再多加贅述。
img=cv2.resize(img,(imgwidth,imgheight))

接著我們將每個像素的值標準化(將介於0~255的整數標準化為0~1.0的浮點數),這個動作可以提高訓練的準確率。
img=img/255.0

然後將處理完的影像依序加入影像清單中。
imglist.append(img)

接著將影像清單轉換成訓練時需要的格式。
img_array=np.array(imglist)

最後,將這些影像儲存在一個size128_F4500_M4500.npy的檔案中。
np.save("size128_F4500_M4500.npy",img_array)

執行後,會得到一個npy檔,裡面裝著4500張男性影像和4500張女性影像。

在下一個章節,我們將建立訓練模型,開始建構這個計畫的核心程式。

2019年4月19日 星期五

使用Keras卷積神經網路辨別肺部醫學影像(二)


本例將辨識肺部X光照片所屬的性別,會利用一個資料檔(.csv)和十二個包含影像檔(.png)的資料夾。


使用Excel開啟附屬的csv檔,查看各張影像的訊息。從資料中可以取出圖片的檔名,疾病、年齡、性別等資料。


從影像資料夾中,可找到資料表中各個影像檔的檔名。

首先,要將資料檔進行分類,先建立兩個空的資料夾,命名為
「image_F」(女性)「image_M」(男性)


接著建立image_M.py檔,將男性影像歸類到指定資料夾。

程式碼及註解如下:

import csv
import os
import glob
from shutil import copyfile
# 開啟 CSV 檔案
with open('Data_Entry_2017.csv', newline='') as csvfile:
    # 讀取 CSV 檔案內容
    rows = csv.DictReader(csvfile)
    #計數器
    count=0
    # 以迴圈輸出每一列
    for row in rows:
        if row['Patient Gender']=='M':#如果性別欄位的值是M
            src='images/'+row['Image Index']#取得影像路徑
            dst='image_M/'+row['Image Index']#目標影像路徑
            if  os.path.exists(src):#如果檔案存在
                    copyfile(src, dst)#將影像複製到目標資料夾   
                    count=count+1#計錄目前的進度
                    if count%100==0:#顯示進度
                        print(count)

接著執行程式,過程中會顯示進度。


接著複製程式碼到image_F.py檔。


注意反白處,要將F更改為M:

import csv
import os
import glob
from shutil import copyfile
# 開啟 CSV 檔案
with open('Data_Entry_2017.csv', newline='') as csvfile:
    # 讀取 CSV 檔案內容
    rows = csv.DictReader(csvfile)
    #計數器
    count=0
    # 以迴圈輸出每一列
    for row in rows:
        if row['Patient Gender']=='F':#如果性別欄位的值是M
            src='images/'+row['Image Index']#取得影像路徑
            dst='image_F/'+row['Image Index']#目標影像路徑
            if  os.path.exists(src):#如果檔案存在
                    copyfile(src, dst)#將影像複製到目標資料夾   
                    count=count+1#計錄目前的進度
                    if count%100==0:#顯示進度
                        print(count)

接著執行後,得到了兩個分別裝著男性肺部影像與女性肺部影像的資料夾。
下一回將示範如何將數千個影像檔打包為一個資料檔。
下一章「使用Keras卷積神經網路辨別肺部醫學影像(三)」

使用Keras卷積神經網路辨別肺部醫學影像(一)

本系列文章將使用Keras卷積神經網路(CNN)辨別肺部醫學影像。

在開始之前,需要額外準備以下Python套件:
  • numpy
  • opencv
  • keras

同時亦需準備一定數量的影像檔(.jpeg、.png)與資料檔(.csv):


本範例所採用的檔案來自於這個網站:

https://nihcc.app.box.com/v/ChestXray-NIHCC

我們先從簡單的範例開始,下一篇將以辨識肺部X光照片所屬的性別為例。

下一章「使用Keras卷積神經網路辨別肺部醫學影像(二)」